MCP가 무엇인지
안녕하세요. novice-22입니다. 앞으로 MCP 서버에 대해서 시리즈 형태로 글을 올릴 예정입니다.
첫 번째 글로는 MCP가 무엇인지에 대해서 정리했습니다. MCP에 대해 기본적으로 알아야 할 내용들로만 작성하였고 더 자세한 내용은 아래의 MCP 공식 문서를 참고하시면 됩니다.
What is the Model Context Protocol (MCP)? - Model Context Protocol
 What is the Model Context Protocol (MCP)? - Model Context Protocol
다음 글부터는 아래 주제로 이어집니다. 제목을 클릭하시면 해당 글로 이동됩니다.
- 환율 MCP 서버 구축하기 (예정)
- MCP에서 발생하는 취약점의 유형에 대해서 (예정)
- MCP 취약점 찾는 방법에 대해서 (예정)
1. MCP란 무엇인가
1-1 MCP란?
MCP(Model Context Protocol)는 AI 애플리케이션과 외부 데이터 소스나 도구를 표준화된 방식으로 연결해주는 개방형 통신 규약이다.
간단하게 요약하자면 MCP는 AI 애플리케이션에 도구를 꽂는 USB-C 규격 같은 것이다. 규격에 맞추어 만들어두면 어느 AI 애플리케이션에서든 같은 도구를 꽂아 쓸 수 있기 때문이다.
1-2 MCP가 나오게 된 배경
나오게 된 배경을 알려면 먼저 LLM의 한계를 알아야 한다.
| 한계 | 무슨 뜻인가 | 예시 |
|---|---|---|
| 학습한 시점까지만 안다 | 학습이 끝난 이후에 일어난 일은 알지 못한다 | "오늘 달러 환율 얼마야?" → 답하지 못함 |
| 내 데이터를 모른다 | 내 PC의 파일이나 사내 데이터에는 접근할 수단 자체가 없다 | "내 바탕화면 파일 목록 보여줘" → 불가능 |
| 실행할 수 없다 | 글을 만들 뿐, 실제 행동은 하지 못한다 | "이 내용 메일로 보내줘" → 메일 본문만 써줌 |
세 가지 한계의 원인은 하나다. LLM은 자기 안에 들어있는 것만 쓸 수 있다. 바깥과 연결되지 않으면 아무리 물어봐도 오늘 날씨를 알려줄 수 없는 것처럼 말이다. 그래서 LLM은 외부와 통신하고 연결할 수 있는 도구가 필요하게 되었다.
그런데 도구를 연결하는 방식이 AI 애플리케이션마다 제각각이었다. 날씨 도구를 하나 만들었다고 해보자.
- ChatGPT에 연결하려면 → ChatGPT의 방식으로 만들어야 함
- Claude에 연결하려면 → Claude의 방식으로 만들어야 함
- Gemini에 연결하려면 → Gemini의 방식으로 만들어야 함
기능은 똑같은데 AI 애플리케이션마다 새로 만들어야 했다. 연결하고 싶은 도구가 M개, 연결할 AI 애플리케이션이 N개라면 만들어야 할 연동은 M × N개가 된다.
이러한 이유로 MCP가 만들어졌다. MCP는 가운데에 공통 규격을 하나 끼워 넣는다.
- 도구를 만드는 쪽은 → MCP 서버 하나만 만들면 된다
- AI 애플리케이션을 만드는 쪽은 → MCP 클라이언트를 한 번만 구현하면 된다
| 도구 수 / 애플리케이션 수 | 기존 방식 (M × N) | MCP (M + N) |
|---|---|---|
| 3 / 3 | 9개 | 6개 |
| 10 / 5 | 50개 | 15개 |
| 50 / 10 | 500개 | 60개 |
2. MCP 구조에 대해서
2-1 Host / Client / Server / LLM 역할
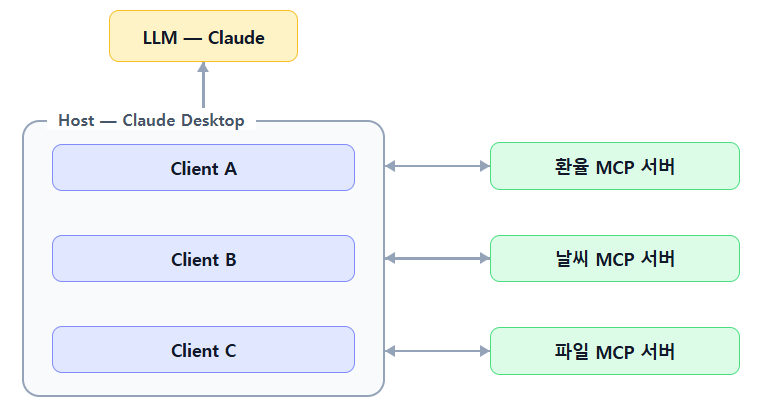
MCP 구조에 대해서 알려면 먼저 Host, Client, Server에 대해 알아야 합니다. 그전에 MCP 구조를 설명하는 글들을 보면 대부분 Host, Client, Server 3개를 다루지만 저는 LLM까지 포함한 총 4개의 구조로 설명을 합니다. 각각의 역할은 아래의 표에 정리했습니다.
| 구성 | 설명 | 예시 |
|---|---|---|
| Host (호스트) | 사용자가 직접 사용하는 AI 애플리케이션이다. LLM과 Client의 중계를 맡는다 | Claude Desktop |
| Client (클라이언트) | Host와 Server의 중간다리 역할이다. MCP 서버와는 1대1로 통신한다 | Client A → 환율 MCP 서버 |
| Server (서버) | 도구를 가지고 있는 서버이다. Host와는 별개로 실행되는 프로그램이다 | 환율 MCP 서버 |
| LLM (AI) | 어떤 도구를 사용할지 판단한다. 도구를 호출하기 위해 Host에 요청한다 | Claude |
2-2 실제 동작 흐름
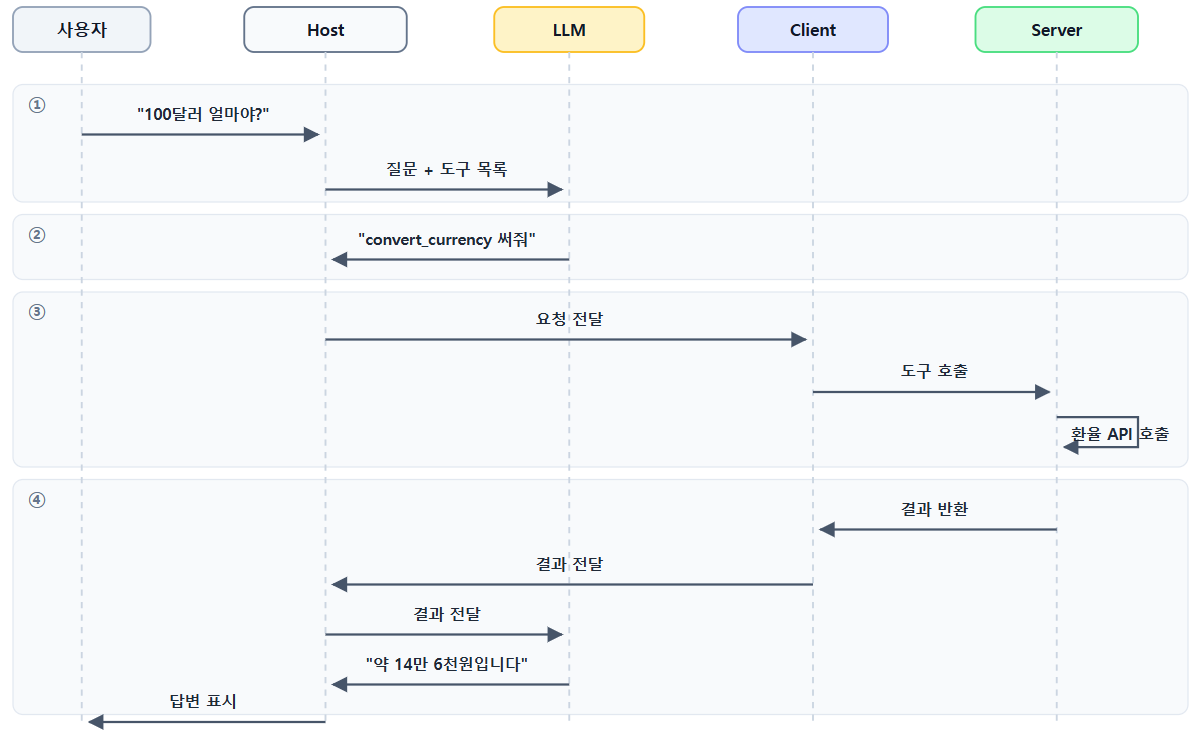
흐름을 보기 전에 준비 단계가 하나 있다. AI 애플리케이션을 켜면 Host가 설정 파일을 읽어 등록된 MCP 서버를 실행시키고, 각 서버에 어떤 도구가 있는지 미리 받아둔다. 여기까지 끝나야 아래 흐름이 시작된다.
① 질문이 LLM에게 전달된다
사용자가 "100달러 얼마야?"라고 묻는다. Host는 이 질문을 LLM에게 그대로 넘기지 않는다. 가지고 있는 도구 목록과 함께 LLM에게 전달한다. LLM은 이 시점에서 "환율을 변환하는 도구가 있다"는 사실을 알게 된다.
② LLM이 도구를 고른다
LLM이 판단한다. "이건 환율 도구를 써야 한다." 그리고 Host에게 요청한다. convert_currency를 amount=100, from=USD, to=KRW 값으로 써달라는 내용이다. LLM이 하는 일은 여기까지다. 고르기만 할 뿐 직접 실행하지는 않는다.
③ Host → Client → Server 순으로 전달되어 실행된다
Host는 convert_currency가 환율 MCP 서버의 도구임을 확인하고, 환율 MCP 서버와 연결된 Client A에게 넘긴다. Client A는 환율 MCP 서버에 도구 호출을 전달하고, 환율 MCP 서버가 실제로 환율 API를 호출하여 결과를 받아온다.
④ 다시 역순으로 Server → Client → Host로 전달된다
환율 MCP 서버가 받아온 결과를 Client A를 거쳐 Host에 전달하고 Host는 다시 LLM에게 전달한다. LLM은 받은 숫자를 문장으로 풀어 답한다. 사용자는 "100달러는 약 14만 6천 원입니다"라는 답변을 받게 된다.
Client ↔ Server
Client가 Server에 보내는 요청은 아래와 같다.
날씨 MCP 서버에 도구 하나를 호출해달라는 내용이다. method에 tools/call을 넣어 도구를 호출하겠다는 뜻을 밝히고, params.name에 get_weather를 넣어 어느 도구인지 지정한다. arguments에는 도구가 받을 값이 들어간다. _meta는 모든 요청에 반드시 들어가야 하는 필드로, 프로토콜 버전과 클라이언트 정보를 실어 보낸다.
{
  "jsonrpc": "2.0",
  "id": 2,
  "method": "tools/call",
  "params": {
    "name": "get_weather",
    "arguments": { "location": "New York" },
    "_meta": {
      "io.modelcontextprotocol/protocolVersion": "2026-07-28",
      "io.modelcontextprotocol/clientInfo": { "name": "ExampleClient", "version": "1.0.0" },
      "io.modelcontextprotocol/clientCapabilities": {}
    }
  }
}
Server가 돌려주는 응답은 아래와 같다.
{
  "jsonrpc": "2.0",
  "id": 2,
  "result": {
    "resultType": "complete",
    "content": [
      {
        "type": "text",
        "text": "Current weather in New York:\nTemperature: 72°F\nConditions: Partly cloudy"
      }
    ],
    "isError": false
  }
}jsonrpc는 JSON-RPC 2.0 규격을 따른다는 표시이고, id가 요청과 같은 2이므로 위 요청에 대한 응답임을 알 수 있다. resultType의 complete는 응답이 완결되었다는 뜻이다. 서버가 추가 입력을 요구하는 경우에는 input_required가 온다. 호출이 성공했는지는 isError로 판단하며, 여기서는 false이므로 정상 처리된 것이다. content에는 실제 결과가 담긴다. 위에서 지정한 New York의 날씨를 조회한 결과가 텍스트로 들어있다.
MCP의 모든 메시지는 이런 JSON-RPC 형식이다. 전송 방식은 2-5에서 다룬다.
2-3 왜 이런 구조인가
MCP 공식 문서에 설계 원칙이 명시되어 있다. 아래는 공식 문서를 번역한 내용이다.
① 서버는 만들기 쉬워야 한다
- 복잡한 조율 책임은 Host 애플리케이션이 맡는다
- 서버는 명확히 정의된 특정 기능에만 집중한다
- 단순한 인터페이스가 구현 부담을 최소화한다
- 명확한 역할 분리가 유지보수 가능한 코드를 만든다
② 서버는 조합할 수 있어야 한다
- 각 서버는 독립적으로 한정된 기능을 제공한다
- 여러 서버를 매끄럽게 조합할 수 있다
- 공통 프로토콜이 상호 운용성을 가능하게 한다
- 모듈식 설계가 확장성을 뒷받침한다
③ 서버는 전체 대화를 볼 수 없고, 다른 서버를 들여다볼 수도 없다
- 서버는 필요한 맥락 정보만 받는다
- 전체 대화 기록은 Host에 남는다
- 각 서버는 격리를 유지한다
- 서버 간 상호작용은 Host가 통제한다
- Host 프로세스가 보안 경계를 강제한다
④ 기능은 점진적으로 추가할 수 있다
- 핵심 프로토콜은 최소한의 필수 기능만 제공한다
- 추가 기능은 필요에 따라 협상할 수 있다
- 서버와 클라이언트는 각자 독립적으로 발전한다
- 프로토콜은 향후 확장성을 염두에 두고 설계되었다
- 하위 호환성이 유지된다
Host의 책임
공식 문서는 Host의 책임으로 다음을 명시한다.
- 여러 Client 인스턴스를 생성하고 관리한다
- Client의 연결 권한과 수명주기를 통제한다
- 보안 정책과 동의 요구사항을 강제한다
- 사용자 승인 결정을 처리한다
- AI/LLM 통합과 샘플링을 조율한다
- 여러 Client에 걸친 컨텍스트 취합을 관리한다
출처: MCP 공식 스펙 - Architecture (2026-07-28 버전)
2-4 서버가 제공하는 3가지: Tools / Resources / Prompts
서버가 제공하는 것은 Tools, Resources, Prompts 세 가지다. 공식 문서에서는 이 셋을 primitive(기본 요소)라고 부른다. 아래는 간단하게 표로 정리한 내용이다.
| 구분 | 제어 주체 | 설명 | 예시 |
|---|---|---|---|
| Tools | 모델(LLM) | 모델이 호출해서 동작시키는 함수 | API 요청, 파일 쓰기 |
| Resources | 애플리케이션(Host) | 애플리케이션이 맥락에 붙여주는 데이터 | 파일 내용, git 기록 |
| Prompts | 사용자(사람) | 사용자가 선택해서 불러오는 대화형 템플릿 | 슬래시 명령, 메뉴 옵션 |
Tools - 모델 제어 방식
모델이 도구 목록을 보고 스스로 판단해 호출을 요청하면, Server가 실행해 외부와 통신하고 결과를 돌려준다.
- 환율 조회, 날씨 조회
- 파일 저장, 이메일 발송
- 데이터베이스 조회 및 수정
실제로 동작을 실행시킨다는 점이 나머지 둘과 다르다. Resources는 읽기만 하고 Prompts는 문장을 채워줄 뿐이지만, Tools는 파일을 저장하고 메일을 보낸다.
공식 문서의 예시는 다음과 같다. 날씨를 조회하는 get_weather 도구다.
{
  "name": "get_weather",
  "title": "Weather Information Provider",
  "description": "Get current weather information for a location",
  "inputSchema": {
    "type": "object",
    "properties": {
      "location": {
        "type": "string",
        "description": "City name or zip code"
      }
    },
    "required": ["location"]
  }
}
도구 이름(name), 설명(description), 받을 값의 형식(inputSchema)으로 이루어진다. 모델은 이 정보를 보고 어떤 도구를 어떤 값으로 써야 할지 판단한다.
Resources - 애플리케이션 중심적
애플리케이션이 맥락에 붙여주는 데이터다. 공식 문서는 각 리소스가 URI로 고유하게 식별된다고 명시한다.
- file:///project/README.md → 특정 파일의 내용
- git:// → 커밋 기록
- 데이터베이스 스키마, API 문서
공식 문서의 예시는 다음과 같다. 프로젝트의 소스 파일 하나를 리소스로 내놓은 경우다.
{
  "uri": "file:///project/src/main.rs",
  "name": "main.rs",
  "title": "Rust Software Application Main File",
  "description": "Primary application entry point",
  "mimeType": "text/x-rust"
}
Tools와 달리 받을 값(inputSchema)이 없고 주소(uri)가 있다. 이 주소를 지정해 내용을 읽어오는 식이다.
다만 값을 전혀 받지 않는 것은 아니다. 리소스 템플릿(resources/templates/list)을 쓰면 file:///{path}처럼 URI에 파라미터를 두고 값을 받을 수 있다. 위 예시는 파라미터가 없는 정적 리소스다.
공식 문서는 이를 application-driven이라고 표현한다. 사용자가 목록에서 고르게 하거나 자동으로 포함시키는 방식 모두 가능하며, 어떻게 할지는 Host가 정한다. 예시로 환율 서버에 넣는다면 지원하는 통화 목록 정도가 Resources가 될 수 있다.
Prompts - 사용자 제어
사용자가 선택해서 불러오는 템플릿이다. 입력값(파라미터)만 바꿔가며 재사용한다.
- 회의록 요약 양식 - 회의록만 넣으면 정해둔 형식대로 요약해준다
- 이메일 초안 양식 - 받는 사람과 용건만 넣으면 초안이 나온다
- 슬래시 명령으로 노출되는 경우가 많다
공식 문서의 예시는 다음과 같다. 코드 리뷰를 요청하는 code_review 템플릿이다.
{
  "name": "code_review",
  "title": "Request Code Review",
  "description": "Asks the LLM to analyze code quality and suggest improvements",
  "arguments": [
    {
      "name": "code",
      "description": "The code to review",
      "required": true
    }
  ]
}
사용자가 이 템플릿을 고르고 code 값에 코드를 넣으면, 서버가 완성된 문장을 만들어 돌려준다. 공식 문서의 결과 예시는 "Please review this Python code:" 뒤에 넣은 코드가 붙은 형태다.
사용자가 직접 선택하여 실행시키는 형태이다.
서버에 보내는 메서드
셋 모두 구조가 같다. 목록을 조회하는 메서드(list)와 하나를 지정해 사용하는 메서드(call / read / get)가 기본으로 존재한다.
| 구분 | 목록 조회 | 실제 사용 |
|---|---|---|
| Tools | tools/list | tools/call |
| Resources | resources/list | resources/read |
| Prompts | prompts/list | prompts/get |
조회 계열 응답에는 ttlMs와 cacheScope가 필수로 붙는다. ttlMs는 이 응답을 얼마나 캐시해도 되는지 알려주는 값이고, cacheScope는 public이면 공유 중간 장비가 캐시해도 되고 private이면 안 된다는 뜻이다. tools/list, prompts/list, resources/list, resources/read, resources/templates/list 결과에 적용된다.
클라이언트가 제공하는 기능
서버만 무언가를 제공하는 것은 아니다. 클라이언트도 서버에게 제공하는 기능이 있다.
| 기능 | 내용 | 상태 |
|---|---|---|
| Elicitation | 서버가 사용자에게 입력을 요청한다 | 현행 |
| Sampling | 서버가 클라이언트에게 LLM 호출을 요청한다 | 폐기 예정 |
| Roots | 클라이언트가 서버에게 작업 범위를 알려준다 | 폐기 예정 |
지금까지 본 흐름과 방향이 반대다. 서버가 클라이언트에게 요청하는 경우이다.
다만 서버가 JSON-RPC 요청을 직접 보내지는 않는다. 서버는 resultType이 input_required인 결과를 반환하면서 필요한 정보 요청을 inputRequests 필드에 담아 보낸다. 클라이언트는 원래 요청을 다시 보내면서 inputResponses에 값을 채워 응답한다. 이 방식을 공식 문서는 MRTR(Multi Round-Trip Requests)이라고 부른다.
Sampling과 Roots는 2026-07-28에서 폐기되었다. 폐기 기간 동안 동작은 하지만 새 구현은 채택하지 않을 것을 권고한다. 공식 문서가 제시하는 대체 방안은 다음과 같다.
- Roots → 디렉터리나 파일을 도구 파라미터, 리소스 URI, 서버 설정으로 전달
- Sampling → LLM 제공자 API와 직접 연동
같은 시점에 Logging도 폐기되었다. 서버가 클라이언트에게 로그 메시지를 보내는 기능이다. 클라이언트가 logging/setLevel로 어느 수준까지 받을지 정하면, 서버가 지정된 수준 이상의 로그를 MCP 메시지로 흘려보내는 식이었다.
방향이 바뀌어서 로그를 MCP 통로로 보내지 않는 쪽으로 정리되었다. stdio라면 서버가 stderr에 직접 쓰고, 별도 관측이 필요하면 OpenTelemetry를 쓰라고 명시한다. 레벨 지정용이던 logging/setLevel은 아예 제거되었다.
Roots, Sampling, Logging 세 기능 모두 제거 가능 시점은 2027-07-28 이후 첫 개정판이다.
출처: MCP 공식 스펙 - Server (2026-07-28 버전)
2-5 통신 방식: stdio vs HTTP
MCP 메시지는 전부 JSON-RPC 형식이어야 하고 UTF-8로 인코딩되어야 한다.
통신 방식(transport)으로는 stdio와 Streamable HTTP가 있다. 둘 다 프로토콜이 아니라 메시지를 실어 나르는 방식이다. stdio는 로컬에서 서버를 직접 실행할 때 쓰고, Streamable HTTP는 외부와 통신이 필요할 때 쓴다. 아래의 표에 간단하게 정리해놨다.
| 구분 | stdio | Streamable HTTP |
|---|---|---|
| 서버 위치 | 내 PC (클라이언트가 직접 실행) | 별도 프로세스 또는 원격 |
| 전달 통로 | 표준 입출력 스트림 | HTTP POST |
| 메시지 단위 | 한 줄에 하나 | 요청 하나당 POST 하나 |
| 주로 쓰는 곳 | 로컬 서버 | 원격 서버 |
stdio
클라이언트가 MCP 서버를 자식 프로세스로 실행하고, 프로세스의 표준 스트림으로 대화한다.
- 서버는 stdin에서 메시지를 읽고 stdout으로 쓴다
- 메시지는 개행으로 구분되며, 메시지 안에 개행이 들어가서는 안 된다
- 서버는 stdout에 유효한 MCP 메시지 외에는 아무것도 쓰면 안 된다
- 로그는 stderr로 보낸다. 클라이언트는 stderr 출력을 오류로 단정하지 않는다
실제로는 이런 줄이 오간다.
{"jsonrpc":"2.0","id":1,"method":"tools/call","params":{"name":"get_weather","arguments":{"location":"New York"},"_meta":{"io.modelcontextprotocol/protocolVersion":"2026-07-28","io.modelcontextprotocol/clientCapabilities":{}}}}종료는 클라이언트가 입력 스트림을 닫는 것으로 시작한다. 서버는 stdin이 닫히면 스스로 종료해야 하고, 응답이 없으면 클라이언트가 강제로 프로세스를 종료시킨다.
Streamable HTTP
서버가 단일 엔드포인트 하나를 POST로 열어둔다. 예를 들면 https://example.com/mcp 같은 주소다. 모든 JSON-RPC 메시지가 각각 하나의 POST 요청이 된다.
엔드포인트를 구현할 때 공식 문서가 명시하는 것은 세 가지다.
- 서버는 모든 연결에서
Origin헤더를 검증해야 한다. 유효하지 않으면403 Forbidden - 로컬 실행 시에는 모든 인터페이스(0.0.0.0)가 아니라 로컬호스트(127.0.0.1)에만 바인딩하는 것을 권장한다
- 모든 연결에 인증을 구현하는 것을 권장한다
응답은 둘 중 하나다.
application/json- 단일 JSON 객체text/event-stream- SSE 스트림이 클라이언트가 보낸 POST 요청의 응답 본문이 된다. 서버에서 클라이언트로 단방향으로 흐른다
요청 양식은 아래와 같다. 공식 문서 예시에는 Accept 헤더가 빠져 있는데, 예시는 헤더가 본문 값을 어떻게 복사해 오는지 보여주는 용도라 완전한 요청 형태가 아니다. 실제로 보낼 때는 Accept까지 들어가야 한다.
POST /mcp HTTP/1.1
Content-Type: application/json
Accept: application/json, text/event-stream
MCP-Protocol-Version: 2026-07-28
Mcp-Method: tools/call
Mcp-Name: get_weather

{
  "jsonrpc": "2.0",
  "id": 1,
  "method": "tools/call",
  "params": {
    "name": "get_weather",
    "arguments": { "location": "Seattle, WA" },
    "_meta": {
      "io.modelcontextprotocol/protocolVersion": "2026-07-28",
      "io.modelcontextprotocol/clientInfo": { "name": "ExampleClient", "version": "1.0.0" },
      "io.modelcontextprotocol/clientCapabilities": {}
    }
  }
}
헤더는 요청 종류에 따라 요구 범위가 다르다.
| 헤더 | 필수 범위 |
|---|---|
MCP-Protocol-Version | 모든 요청 |
Mcp-Method | 모든 요청 |
Mcp-Name | tools/call, resources/read, prompts/get 요청 |
Accept | 모든 요청. application/json과 text/event-stream을 모두 명시해야 한다 |
Accept에 두 가지를 다 적는 이유는 서버가 둘 중 어느 형식으로 답할지 고르기 때문이다. 클라이언트는 둘 다 받을 수 있어야 한다.
Accept를 제외한 세 개의 헤더는 본문에 있는 값을 그대로 복사한 것이다. method는 Mcp-Method로, params.name은 Mcp-Name으로, _meta의 프로토콜 버전은 MCP-Protocol-Version으로 간다. 같은 값을 헤더에도 두는 이유는, 중간 장비가 본문을 파싱하지 않고도 라우팅과 검사를 할 수 있게 하기 위해서다.
다만 기준은 언제나 본문이다. 헤더 값과 본문 값이 다르면 서버는 400 Bad Request와 함께 HeaderMismatch(코드 -32020) 오류를 반환한다. 공식 문서는 로드밸런서가 헤더를 보고 라우팅하는데 서버는 본문을 보고 실행하는 상황을 막기 위함이라고 설명한다.
MCP의 에러는 두 종류다.
| 종류 | 어디에 담기나 | 예 |
|---|---|---|
| 프로토콜 에러 | JSON-RPC error 객체 | 없는 도구 호출, 잘못된 요청 형식 |
| 도구 실행 에러 | 정상 응답의isError: true | API 실패, 입력값 범위 오류 |
없는 도구를 부르면 요청 자체가 성립하지 않으니 error 객체로 돌아온다. 반면 도구는 제대로 불렀는데 환율 API가 응답하지 않았다면, 프로토콜 수준에서는 정상 응답이고 결과 안의 isError: true로 실패를 알린다.
나눈 기준은 모델이 스스로 고칠 수 있느냐다. Invalid departure date: must be in the future 같은 도구 실행 에러는 모델이 읽고 값을 고쳐 재시도할 수 있지만, 프로토콜 에러는 모델이 고치기 어렵다.
에러 코드는 구간이 나뉘어 있어서, 번호를 보고 누가 정의한 에러인지 알 수 있다.
| 구간 | 정의 주체 |
|---|---|
-32700~-32603 | JSON-RPC 표준 |
-32000~-32019 | 정책 이전에 구현들이 쓰던 구간 (신규 사용 금지) |
-32020~-32099 | MCP 스펙 예약 |
-32020 이상은 어느 MCP 구현에서나 같은 의미다. 반면 -32000 ~ -32019는 이 정책이 생기기 전에 구현들이 임의로 쓰던 구간이다. 새 코드를 여기 할당해서는 안 되고, 받는 쪽도 특정 의미를 가정해서는 안 된다.
스펙이 예약 구간에 정의한 코드는 현재 셋이다.
-32020HeaderMismatch- 헤더와 본문 값 불일치-32021MissingRequiredClientCapability- 필요한 클라이언트 능력 누락-32022UnsupportedProtocolVersion- 지원하지 않는 프로토콜 버전
폐기된 전송 방식: HTTP + SSE
2024-11-05 버전에는 HTTP+SSE라는 전송 방식이 있었다. 2025-03-26 개정에서 Streamable HTTP로 대체되며 폐기되었고, 공식 문서는 서버를 구현할 때 HTTP+SSE를 채택하지 않을 것을 권고한다. 향후 개정에서 제거될 수 있다.
구조가 지금과 달랐다. 엔드포인트가 두 개였다.
- 클라이언트가
GET으로 SSE 스트림을 연다. 첫 이벤트로 서버가endpoint주소를 알려준다 - 클라이언트가 보낼 메시지는
endpoint로 받은 주소로POST요청을 한다
클라이언트가 GET으로 SSE 스트림을 열게 된다. 서버는 해당 요청을 받으면 endpoint 주소를 클라이언트에게 알려주고, 클라이언트는 요청할 메시지를 endpoint 주소로 POST 형식으로 보내게 된다. 그리고 서버는 처음에 클라이언트가 열었던 SSE 스트림으로 응답을 하게 된다. 요청과 응답이 각각 다른 통로로 이루어진다.
Streamable HTTP의 이전 규격
폐기된 것은 HTTP+SSE만이 아니다. 지금 쓰는 Streamable HTTP도 2026-07-28에서 규격이 바뀌었다. 2025-03-26부터 2025-11-25까지는 다음이 있었으나 현재는 제거되었다.
| 제거된 것 | 현재(2026-07-28 버전) |
|---|---|
Mcp-Session-Id헤더로 세션을 부여하고 DELETE로 종료 | 세션 개념 자체가 없다. 요청마다 _meta에 프로토콜 버전과 능력을 실어 보낸다 |
GET으로 독립적인 SSE 스트림을 여는 것 | GET을 받지 않는다. 장기 알림이 필요하면 subscriptions/listen 요청을 보내고 응답 스트림이 유지된다 |
| 서버가 SSE 스트림으로 JSON-RPC 요청을 보내는 것 | 서버는 요청을 보내지 않는다. 입력이 필요하면 InputRequiredResult를 결과에 담아 반환하고, 클라이언트가 값을 채워 다시 요청한다 |
Last-Event-ID로 끊긴 스트림을 재개하는 것 | 재개할 수 없다. 끊기면 새 요청 ID로 다시 보내야 한다 |
프로토콜 전반에서 제거된 것
위는 Streamable HTTP에만 해당하는 변경이다. 전송 방식과 무관하게 프로토콜 자체에서 제거된 것도 있다. 아래는 stdio에도 똑같이 해당된다.
| 제거된 것 | 현재(2026-07-28 버전) |
|---|---|
initialize/ notifications/initialized 핸드셰이크 | 제거되었다. 서버는 server/discover를 반드시 구현해 지원 버전·능력·신원을 알리고, 클라이언트는 다른 요청 전에 이를 호출할 수 있다 |
ping, logging/setLevel,notifications/roots/list_changed | 전부 제거되었다. 로그 레벨은 요청마다 _meta의 io.modelcontextprotocol/logLevel로 지정한다 |
출처: MCP 공식 스펙 - Transports (2026-07-28 버전)